← 回首頁生圖
2026/11/02 01:16
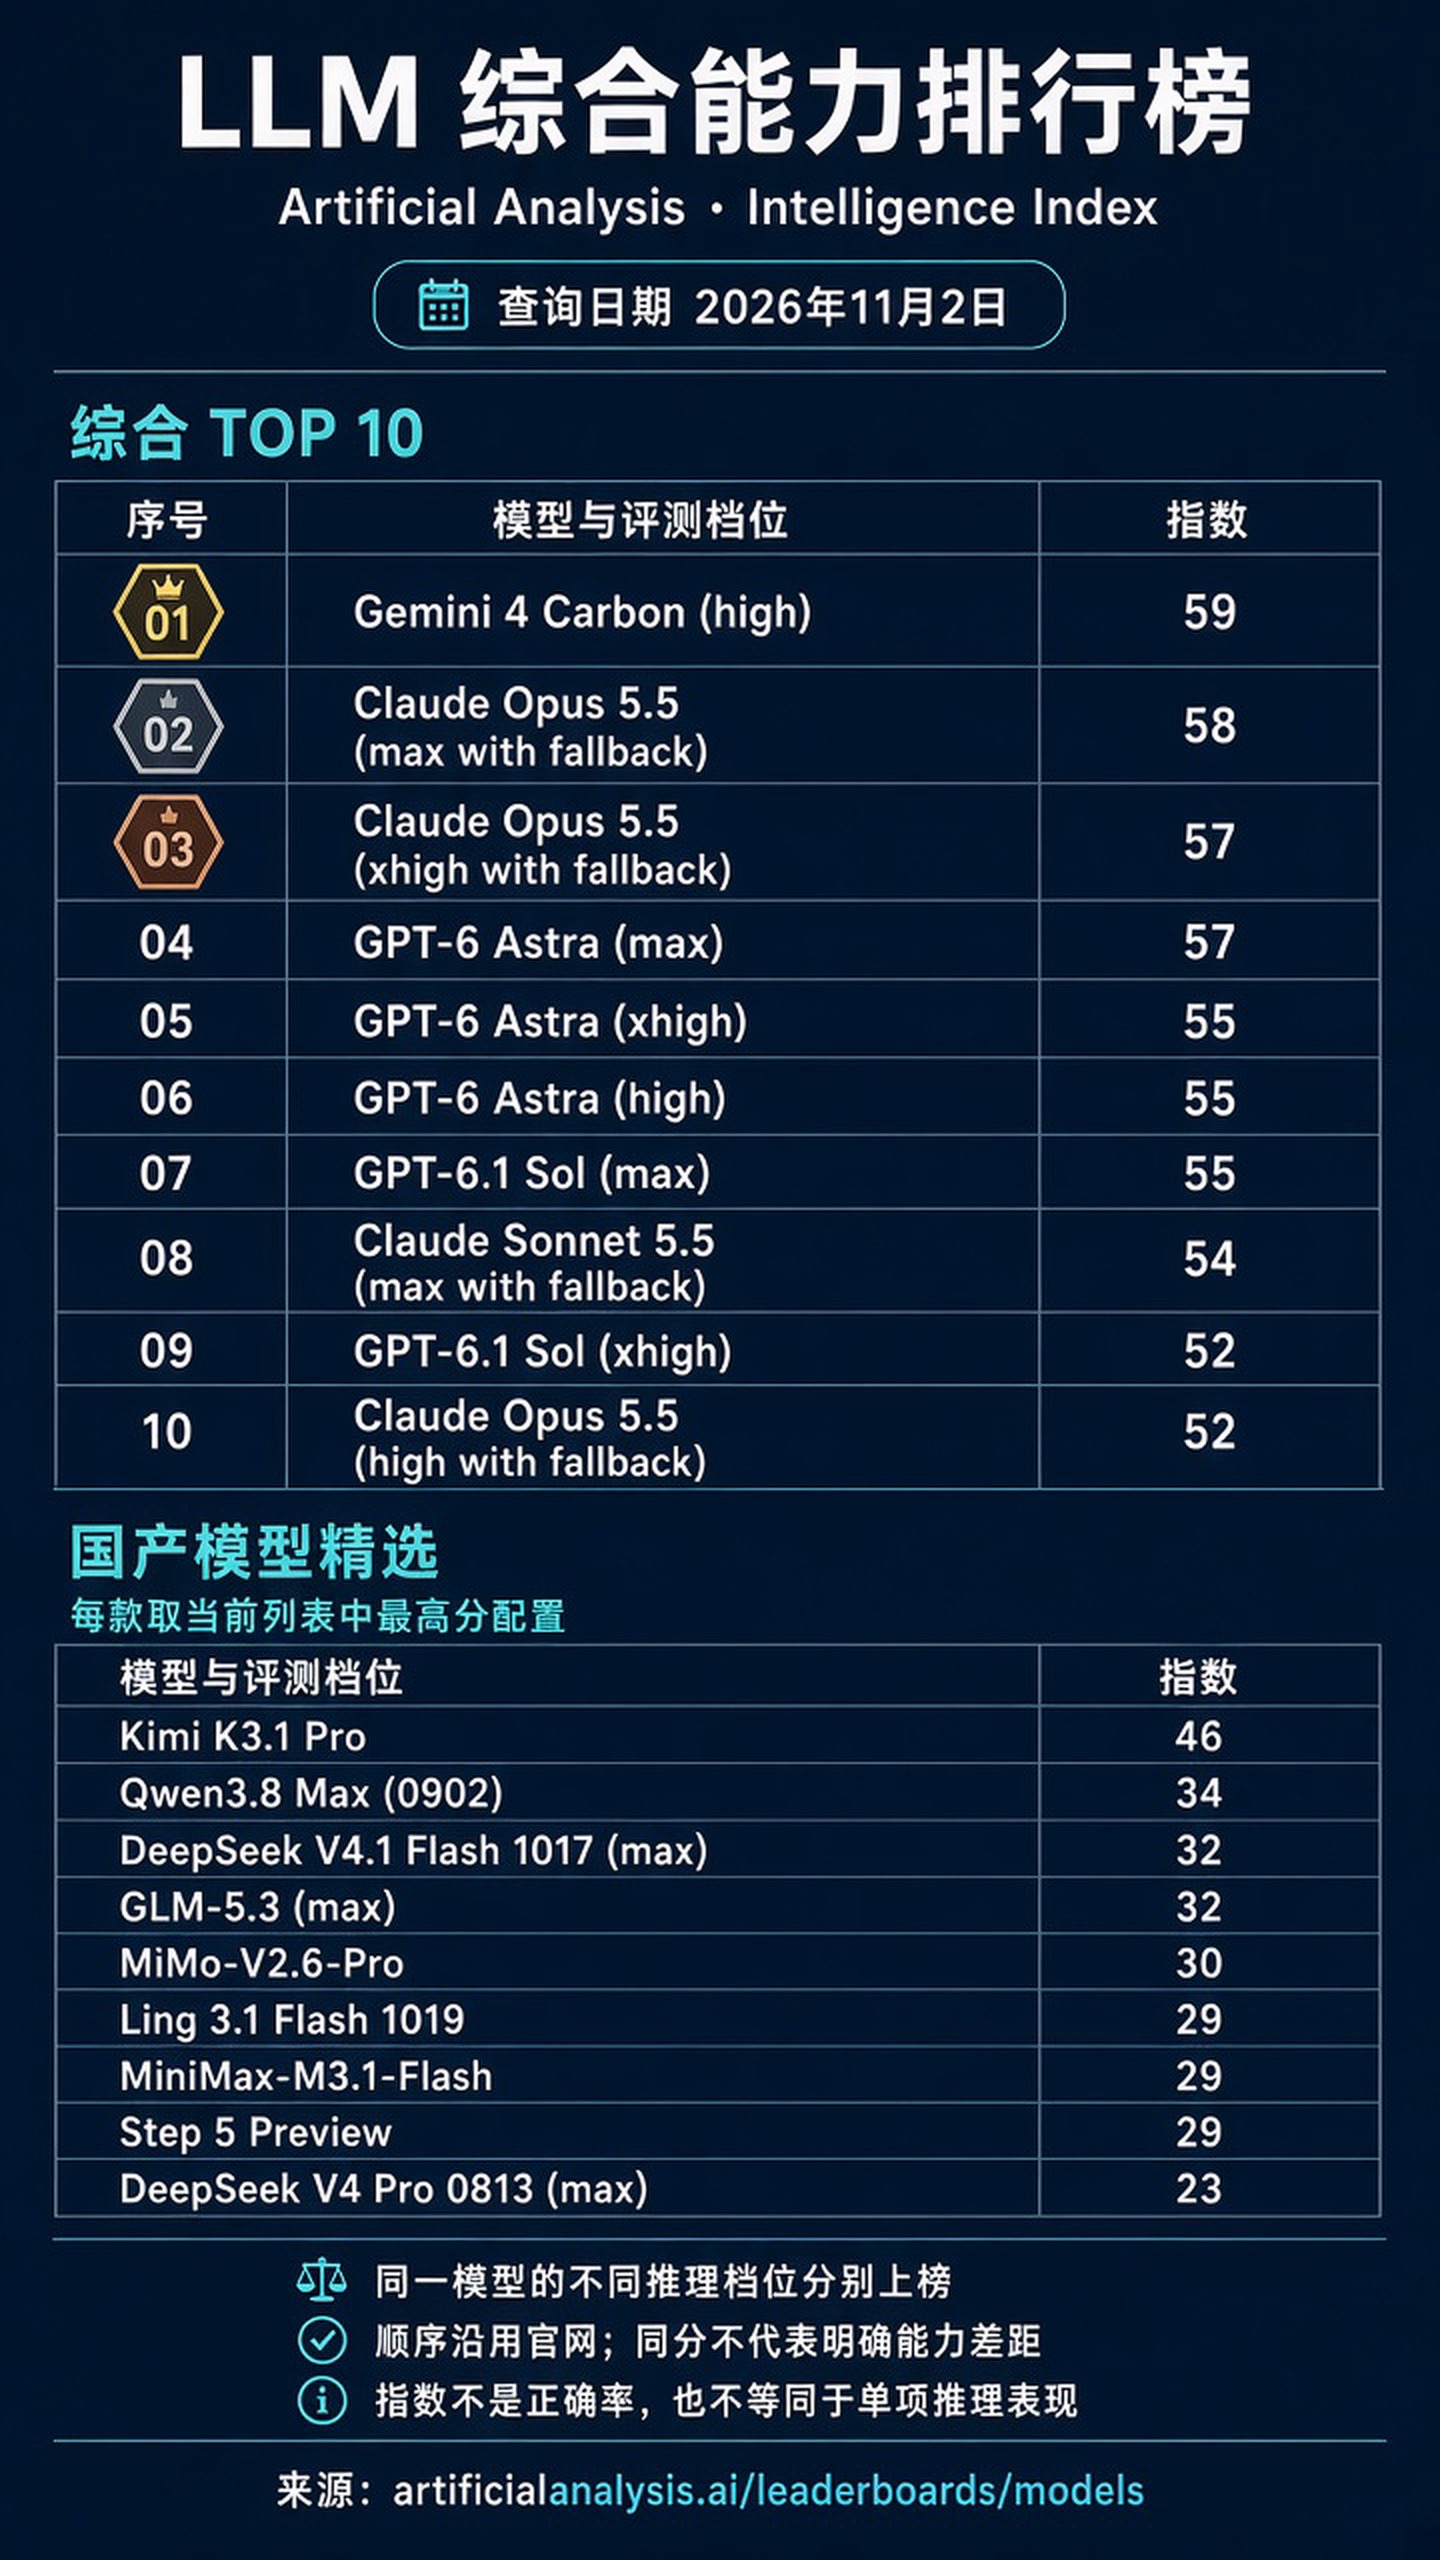
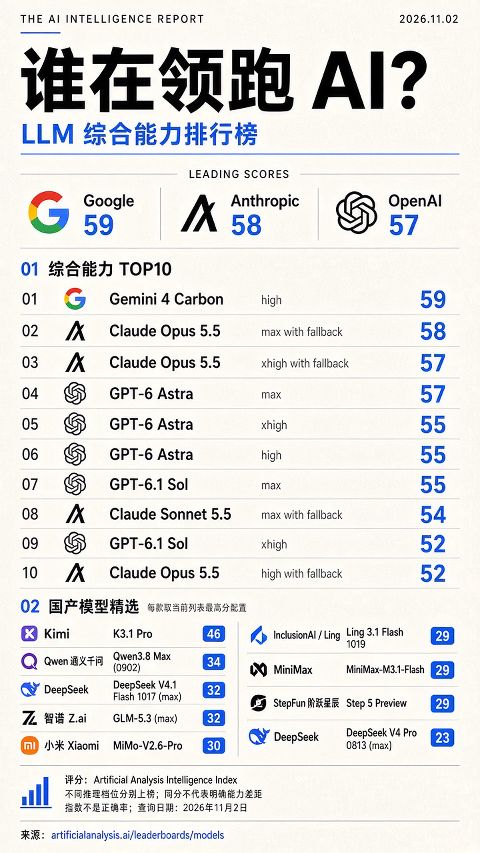
制作一张竖版9:16、2K的中文大语言模型排行榜信息图。专业科技媒体编辑式设计,深海军蓝背景、白色清晰文字、青绿色分区标题与细线,前三名用克制的金银铜小徽章。平面正视,无设备样机、无透视、无水印,不添加任何厂商logo。信息密集但字体必须够大,数字列严格右对齐,行间距整齐,模型名称不截断。所有给定英文名称、数字、标点和中文必须准确。不要添加未经给定的排名或分数。
顶部:
大标题:LLM 综合能力排行榜
副标题:Artificial Analysis · Intelligence Index
日期标签:查询日期 2026年11月2日

上半部分约占全图48%,标题:综合 TOP 10
三列表格:序号|模型与评测档位|指数
01|Gemini 4 Carbon (high)|59
02|Claude Opus 5.5 (max with fallback)|58
03|Claude Opus 5.5 (xhigh with fallback)|57
04|GPT-6 Astra (max)|57
05|GPT-6 Astra (xhigh)|55
06|GPT-6 Astra (high)|55
07|GPT-6.1 Sol (max)|55
08|Claude Sonnet 5.5 (max with fallback)|54
09|GPT-6.1 Sol (xhigh)|52
10|Claude Opus 5.5 (high with fallback)|52
长模型名称可将括号内档位放在该行第二行,以保证完整清晰,不要删除with fallback。

下半部分约占全图33%,标题:国产模型精选
副标题:每款取当前列表中最高分配置
两列表格:模型与评测档位|指数
Kimi K3.1 Pro|46
Qwen3.8 Max (0902)|34
DeepSeek V4.1 Flash 1017 (max)|32
GLM-5.3 (max)|32
MiMo-V2.6-Pro|30
Ling 3.1 Flash 1019|29
MiniMax-M3.1-Flash|29
Step 5 Preview|29
DeepSeek V4 Pro 0813 (max)|23

底部说明用清楚可读的字体:
同一模型的不同推理档位分别上榜
顺序沿用官网;同分不代表明确能力差距
指数不是正确率,也不等同于单项推理表现
来源:artificialanalysis.ai/leaderboards/models

整体强调准确、简洁、秩序感,表格是主体,装饰极少,充分利用纵向空间,完整呈现19条数据,不添加成本、速度或其他额外指标。
🔀 一鍵靈感變體微調(點擊直接帶入生圖)
📋 創作參數與提示詞結構解析
主題分類